Existe um momento interessante no aprendizado de SQL.
Você aprende GROUP BY.
Entende funções como:
SUM()
COUNT()
AVG()
MAX()
MIN()
E começa a resolver vários problemas.
Faturamento por cliente.
Quantidade de pedidos por vendedor.
Média de vendas por produto.
Maior compra por região.
Até que aparece uma pergunta um pouco diferente.
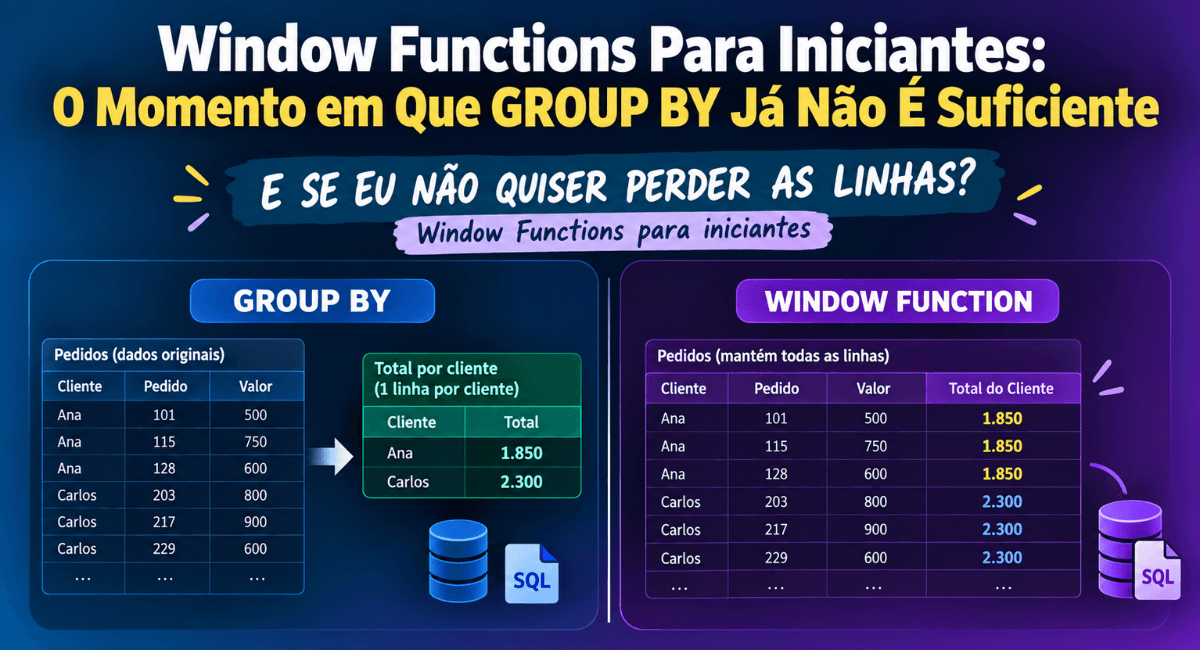
“Quero visualizar cada pedido e, ao lado dele, o total que aquele cliente já comprou.”
Parece simples.
Mas existe um detalhe.
Queremos duas coisas ao mesmo tempo:
o detalhe de cada pedido;
e:
o total agregado do cliente.
É aqui que GROUP BY começa a mostrar uma limitação.
E é exatamente aqui que Window Functions começam a fazer sentido.
Vamos começar pelo problema
Imagine esta tabela:
pedido
-----------------------------------------
ID_PEDIDO
ID_CLIENTE
DATA_PEDIDO
VALOR_TOTAL
E alguns dados:
| ID_PEDIDO | ID_CLIENTE | VALOR_TOTAL |
|---|---|---|
| 101 | 1 | 500,00 |
| 102 | 2 | 900,00 |
| 103 | 1 | 750,00 |
| 104 | 2 | 1.400,00 |
| 105 | 1 | 600,00 |
O gestor pergunta:
“Quero uma lista de todos os pedidos e também quero saber quanto cada cliente comprou no total.”
Vamos pensar antes do SQL.
Para o cliente 1:
500 + 750 + 600 = 1.850Para o cliente 2:
900 + 1.400 = 2.300Mas o resultado desejado não é simplesmente:
| ID_CLIENTE | TOTAL_COMPRADO |
|---|---|
| 1 | 1.850,00 |
| 2 | 2.300,00 |
Queremos isto:
| ID_PEDIDO | ID_CLIENTE | VALOR_TOTAL | TOTAL_CLIENTE |
|---|---|---|---|
| 101 | 1 | 500,00 | 1.850,00 |
| 103 | 1 | 750,00 | 1.850,00 |
| 105 | 1 | 600,00 | 1.850,00 |
| 102 | 2 | 900,00 | 2.300,00 |
| 104 | 2 | 1.400,00 | 2.300,00 |
Perceba a diferença.
Queremos o total.
Mas também queremos manter cada pedido.
O que acontece com GROUP BY?
Se quisermos descobrir o total comprado por cliente, podemos fazer:
SELECT
    ID_CLIENTE,
    SUM(VALOR_TOTAL) AS TOTAL_CLIENTE
FROM pedido
GROUP BY
    ID_CLIENTE;
O resultado seria:
| ID_CLIENTE | TOTAL_CLIENTE |
|---|---|
| 1 | 1.850,00 |
| 2 | 2.300,00 |
A consulta está correta.
Mas algo aconteceu.
Os pedidos individuais desapareceram.
Não temos mais:
101
103
105
Temos apenas:
Cliente 1 → 1.850Por quê?
Porque essa é justamente a função do GROUP BY.
Ele agrupou as linhas.
GROUP BY muda a granularidade
Essa ideia é importante.
Antes do agrupamento:
1 linha = 1 pedido
Depois:
1 linha = 1 cliente
Mudamos aquilo que cada linha do resultado representa.
Isso não é um problema.
Na maioria das vezes, é exatamente o que queremos.
Se a pergunta for:
Quanto cada cliente comprou?
o GROUP BY resolve perfeitamente.
Mas nossa pergunta atual é diferente.
Queremos:
cada pedido + total do cliente.
Não queremos perder a granularidade original.
É aqui que entra a Window Function
Podemos escrever:
SELECT
    ID_PEDIDO,
    ID_CLIENTE,
    VALOR_TOTAL,
    SUM(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_CLIENTE
FROM pedido;
O resultado fica parecido com:
| ID_PEDIDO | ID_CLIENTE | VALOR_TOTAL | TOTAL_CLIENTE |
|---|---|---|---|
| 101 | 1 | 500,00 | 1.850,00 |
| 103 | 1 | 750,00 | 1.850,00 |
| 105 | 1 | 600,00 | 1.850,00 |
| 102 | 2 | 900,00 | 2.300,00 |
| 104 | 2 | 1.400,00 | 2.300,00 |
Agora conseguimos as duas coisas.
Mantivemos:
cada pedido.
E adicionamos:
o total daquele cliente.
Não tente decorar a sintaxe ainda
Quando alguém vê isto pela primeira vez:
SUM(VALOR_TOTAL) OVER (
    PARTITION BY ID_CLIENTE
)
pode parecer estranho.
Então vamos separar.
Primeiro:
SUM(VALOR_TOTAL)Essa parte você provavelmente já conhece.
Significa:
some os valores.
A novidade está aqui:
OVER (
    PARTITION BY ID_CLIENTE
)
Podemos pensar nisso como:
Faça essa soma considerando grupos de clientes, mas sem transformar esses grupos em uma única linha.
Essa última parte é fundamental.
GROUP BY agrupa as linhas
Imagine:
Cliente 1
Pedido 101 → 500
Pedido 103 → 750
Pedido 105 → 600
Com GROUP BY, essas três linhas se transformam em:
Cliente 1 → 1.850Perdemos o detalhe porque pedimos um resultado agregado.
PARTITION BY cria uma janela
Com:
PARTITION BY ID_CLIENTEpodemos imaginar que o SQL cria uma espécie de janela para cada cliente.
Dentro da janela do cliente 1:
Pedido 101 → 500
Pedido 103 → 750
Pedido 105 → 600
A soma é:
1.850Então esse resultado pode aparecer em cada linha pertencente àquela janela:
Pedido 101 → 500 → 1.850
Pedido 103 → 750 → 1.850
Pedido 105 → 600 → 1.850
As linhas continuam existindo.
Essa é a grande diferença.
Pense em “calcular sem desmontar o detalhe”
Essa é uma forma simples de começar a entender Window Functions.
GROUP BY:
resume as linhas.
Window Function:
calcula sobre um conjunto de linhas, mas pode manter as linhas originais no resultado.
Isso abre uma quantidade enorme de possibilidades.
Podemos calcular a média do cliente também
Imagine que queremos mostrar cada pedido e comparar com o valor médio dos pedidos daquele cliente.
Podemos adicionar:
AVG(VALOR_TOTAL) OVER (
    PARTITION BY ID_CLIENTE
) AS MEDIA_CLIENTE
A consulta fica:
SELECT
    ID_PEDIDO,
    ID_CLIENTE,
    VALOR_TOTAL,
    SUM(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_CLIENTE,
    AVG(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS MEDIA_CLIENTE
FROM pedido;
Agora cada pedido pode carregar informações sobre o comportamento daquele cliente.
Podemos contar quantos pedidos o cliente realizou
Também podemos utilizar:
COUNT(*) OVER (
    PARTITION BY ID_CLIENTE
)
Por exemplo:
SELECT
    ID_PEDIDO,
    ID_CLIENTE,
    DATA_PEDIDO,
    VALOR_TOTAL,
    COUNT(*) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_PEDIDOS_CLIENTE
FROM pedido;
Imagine o resultado:
| Pedido | Cliente | Valor | Pedidos do cliente |
|---|---|---|---|
| 101 | 1 | 500 | 3 |
| 103 | 1 | 750 | 3 |
| 105 | 1 | 600 | 3 |
| 102 | 2 | 900 | 2 |
| 104 | 2 | 1.400 | 2 |
Mais uma vez:
mantivemos o pedido.
Mas adicionamos uma informação agregada sobre o cliente.
Agora podemos responder perguntas mais interessantes
Imagine:
Esse pedido representa quanto do total comprado pelo cliente?
Já temos:
VALOR_TOTALe:
TOTAL_CLIENTEEntão podemos calcular:
SELECT
    ID_PEDIDO,
    ID_CLIENTE,
    VALOR_TOTAL,
    SUM(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_CLIENTE,
    VALOR_TOTAL * 100.0
        / SUM(VALOR_TOTAL) OVER (
            PARTITION BY ID_CLIENTE
        ) AS PERCENTUAL_CLIENTE
FROM pedido;
Agora cada pedido mostra sua participação no total daquele cliente.
Isso seria difícil de representar apenas com um GROUP BY mantendo a mesma granularidade.
É por isso que Window Functions aparecem tanto em análise de dados
Muitas análises precisam de duas perspectivas simultâneas.
Queremos olhar para:
a linha individual
e também:
o grupo ao qual aquela linha pertence.
Por exemplo:
- venda + total do vendedor;
- pedido + média do cliente;
- produto + média da categoria;
- funcionário + média salarial do departamento;
- mês + total acumulado;
- atleta + posição no ranking.
Window Functions são extremamente úteis justamente nesse tipo de situação.
PARTITION BY não é GROUP BY
Eles podem parecer semelhantes porque ambos criam grupos lógicos.
Mas existe uma diferença fundamental.
Com:
GROUP BY ID_CLIENTEas linhas são consolidadas.
Com:
PARTITION BY ID_CLIENTEas linhas podem permanecer no resultado.
O agrupamento serve para o cálculo da função de janela.
Essa distinção precisa ficar clara.
E o OVER?
Uma Window Function possui algo característico:
OVER (...)É dentro do OVER que começamos a definir sobre quais linhas aquela função vai trabalhar.
No nosso exemplo:
OVER (
    PARTITION BY ID_CLIENTE
)
significa:
separe logicamente os registros por cliente e faça o cálculo dentro de cada grupo.
Mas o OVER pode fazer mais coisas.
Por exemplo, também pode definir uma ordem.
Quando a ordem começa a importar
Imagine que queremos acompanhar os pedidos de cada cliente ao longo do tempo.
Agora não queremos apenas saber:
Quanto ele comprou no total?
Queremos saber:
Quanto ele havia comprado acumulado até cada pedido?
Veja a diferença.
Cliente 1:
Pedido 101 → 500
Pedido 103 → 750
Pedido 105 → 600
O acumulado seria:
Pedido 101 → 500
Pedido 103 → 1.250
Pedido 105 → 1.850
Agora a ordem das compras importa.
Podemos começar a pensar em:
SUM(VALOR_TOTAL) OVER (
    PARTITION BY ID_CLIENTE
    ORDER BY DATA_PEDIDO
)
Perceba que adicionamos:
ORDER BY DATA_PEDIDOdentro da janela.
Agora o SQL considera a sequência das compras para o cálculo.
Mas existe um detalhe importante no acumulado
Quando trabalhamos com acumulados, vale ter cuidado com pedidos que possuem a mesma data.
Dependendo do banco e da definição padrão da janela, empates no ORDER BY podem produzir um comportamento diferente do que você imaginava.
Se existe uma coluna que define a sequência dos pedidos, podemos tornar a ordenação mais explícita.
Por exemplo:
SUM(VALOR_TOTAL) OVER (
    PARTITION BY ID_CLIENTE
    ORDER BY
        DATA_PEDIDO,
        ID_PEDIDO
    ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
) AS TOTAL_ACUMULADO
Não precisa decorar isso agora.
O ponto é outro:
quando a ordem passa a fazer parte da pergunta, precisamos definir essa ordem com clareza.
Window Functions não servem apenas para SUM
Esse é apenas nosso primeiro exemplo.
Existe uma família inteira de recursos.
Você provavelmente encontrará:
ROW_NUMBER()
RANK()
DENSE_RANK()
LAG()
LEAD()
E cada uma abre novos tipos de análise.
Por exemplo:
Qual foi a primeira compra de cada cliente?
Qual é o ranking de vendedores?
Qual era o valor da compra anterior?
Quanto a venda cresceu em relação ao mês anterior?
Mas eu não tentaria aprender todas de uma vez.
Primeiro entenda a ideia da janela.
Uma pergunta simples para decidir
Quando estiver diante de uma análise, pergunte:
Eu preciso resumir as linhas ou preciso manter o detalhe?
Se você precisa apenas de:
total por cliente,
GROUP BY pode resolver perfeitamente.
Se precisa de:
cada pedido + total do cliente,
uma Window Function começa a ficar interessante.
Essa não é uma regra para todos os casos.
Mas é uma excelente forma de começar a desenvolver a intuição.
Não substitua GROUP BY por Window Functions
Existe outro erro comum.
A pessoa aprende Window Functions e começa a pensar:
“Então
GROUP BYficou ultrapassado.”
Não.
São ferramentas para problemas diferentes.
Se o gestor pergunta:
Qual é o faturamento total por cliente?
Uma consulta simples pode ser:
SELECT
    ID_CLIENTE,
    SUM(VALOR_TOTAL) AS TOTAL_CLIENTE
FROM pedido
GROUP BY
    ID_CLIENTE;
Clara.
Direta.
Resolve exatamente o problema.
Não existe motivo para utilizar uma estrutura mais sofisticada apenas porque você acabou de aprendê-la.
SQL mais avançado não significa SQL mais complicado
Esse é um ponto interessante.
Uma Window Function é normalmente classificada como um recurso mais avançado.
Mas isso não significa que você precisa pensar nela como algo assustador.
Olhe novamente:
SUM(VALOR_TOTAL) OVER (
    PARTITION BY ID_CLIENTE
)
Em português:
Some o valor dos pedidos dentro de cada cliente sem eliminar os pedidos individuais.
Quando entendemos a pergunta, a sintaxe começa a fazer sentido.
O problema continua vindo primeiro
Perceba como chegamos até aqui.
Não começamos perguntando:
Como funciona
PARTITION BY?
Começamos com:
Quero cada pedido e também o total comprado pelo cliente.
Tentamos pensar com GROUP BY.
Percebemos que ele mudaria a granularidade.
Então surgiu a necessidade de calcular sem perder as linhas.
Só depois apareceu:
OVER (
    PARTITION BY ...
)
Esse caminho é importante.
Porque você passa a entender por que o recurso existe.
Um desafio para você
Imagine uma tabela:
venda
----------------
ID_VENDA
ID_VENDEDOR
DATA_VENDA
VALOR_VENDA
A empresa quer um relatório mostrando:
- cada venda;
- o vendedor;
- o valor da venda;
- o total vendido por aquele vendedor.
Tente resolver.
Primeiro pergunte:
Posso usar
GROUP BYsem perder cada venda?
Depois pense em:
SUM(VALOR_VENDA) OVER (
    PARTITION BY ID_VENDEDOR
)
Agora um desafio um pouco maior
A empresa quer mostrar:
cada venda + média de vendas daquele vendedor.
Depois quer identificar se aquela venda ficou:
acima da média;
ou:
abaixo da média.
Você já viu as ferramentas necessárias ao longo de setembro.
Talvez combine:
AVG() OVER(...)com:
CASE WHENPercebe o que está acontecendo?
Os assuntos começam a deixar de existir isoladamente.
Eles começam a trabalhar juntos.
Isso é evolução em SQL
No começo, estudamos:
SELECT.
Depois: WHERE.
Depois:
JOIN.
Depois:
GROUP BY.
Depois:
CASE.
Subquery.
CTE.
Window Functions.
Mas o objetivo não é montar uma coleção de comandos.
O objetivo é chegar ao ponto em que você recebe uma pergunta e pensa:
Qual combinação dessas ferramentas representa melhor o problema?
Foi exatamente sobre isso que falamos no artigo anterior.
Ser bom em SQL não é simplesmente saber mais comandos.
É saber utilizá-los quando fazem sentido.
Um último exemplo
Imagine que queremos mostrar:
cada pedido;
valor do pedido;
total comprado pelo cliente;
média dos pedidos do cliente;
quantidade de pedidos do cliente.
Podemos escrever:
SELECT
    ID_PEDIDO,
    ID_CLIENTE,
    DATA_PEDIDO,
    VALOR_TOTAL,

    SUM(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_CLIENTE,

    AVG(VALOR_TOTAL) OVER (
        PARTITION BY ID_CLIENTE
    ) AS MEDIA_PEDIDO_CLIENTE,

    COUNT(*) OVER (
        PARTITION BY ID_CLIENTE
    ) AS TOTAL_PEDIDOS_CLIENTE

FROM pedido;
Observe a riqueza desse resultado.
Cada linha continua representando:
um pedido.
Mas agora ela também carrega contexto sobre:
o comportamento daquele cliente.
Essa é uma das razões pelas quais Window Functions são tão poderosas para análise de dados.
Conclusão
GROUP BY é uma ferramenta fundamental.
Você vai utilizá-lo inúmeras vezes.
Mas existe um momento em que a pergunta exige algo diferente.
Você precisa calcular:
- totais;
- médias;
- contagens;
- rankings;
- comparações;
- acumulados;
sem necessariamente perder o detalhe das linhas.
É aí que Window Functions começam a abrir uma nova porta.
Não tente decorar todas agora.
Comece entendendo esta diferença:
GROUP BY resume.
Window Function permite analisar grupos mantendo o contexto das linhas.
Depois disso, OVER e PARTITION BY deixam de parecer palavras estranhas.
Passam a representar uma necessidade que você já entende.
E esse é sempre o melhor momento para aprender um novo recurso SQL:
quando você entende qual problema ele veio resolver.
Próximo passo
Se você chegou até Window Functions, provavelmente já percebeu uma mudança importante.
SQL começa a deixar de ser apenas:
SELECT
WHERE
JOIN
GROUP BY
e passa a se tornar uma linguagem muito mais poderosa para análise.
No SQL Simplificado, essa evolução acontece de forma estruturada: começando pelo raciocínio, consolidando os fundamentos e avançando para consultas que exigem cada vez mais capacidade de análise.
O objetivo não é simplesmente chegar ao ROW_NUMBER() ou ao LAG().
É chegar ao ponto em que você entende quando e por que essas ferramentas fazem sentido.
Porque SQL avançado não começa quando você aprende uma sintaxe difícil.
Começa quando os problemas que você consegue resolver também começam a ficar mais interessantes.
Artigos Relacionados


0 Comentários