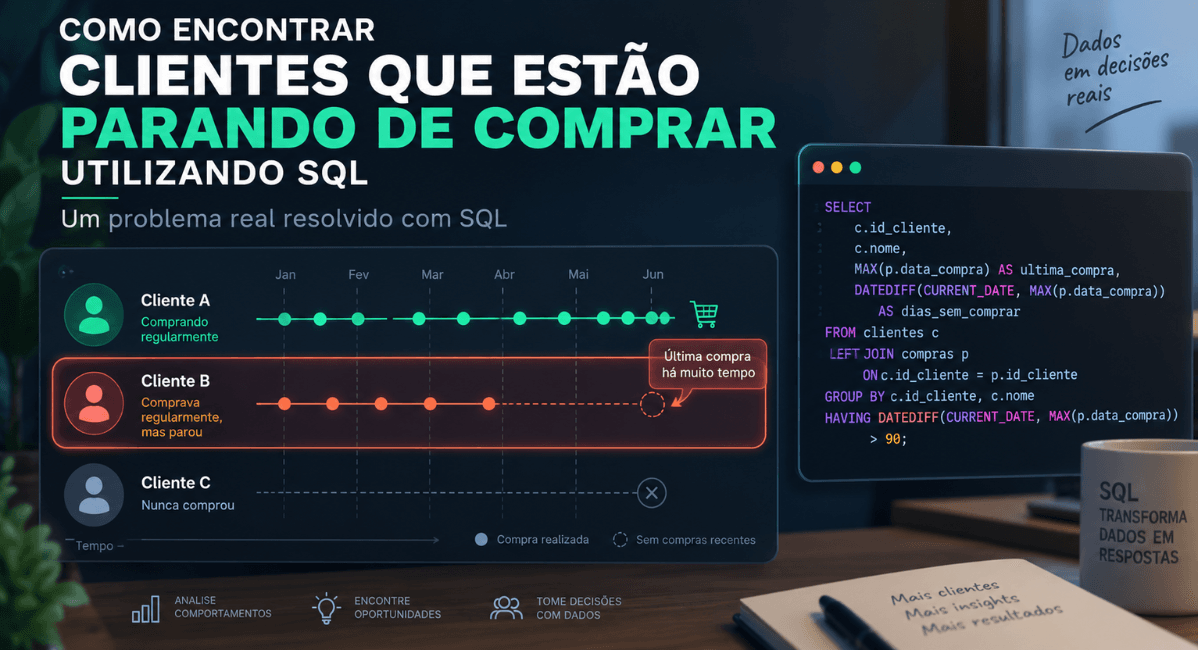
Imagine que você trabalha em um e-commerce.
Seu gestor chega com uma preocupação:
“Temos clientes que compravam da gente e estão sumindo?”
Essa é uma pergunta interessante.
Porque ele não quer saber apenas quem comprou.
Também não quer saber quem nunca comprou.
Ele quer identificar um comportamento:
clientes que já tiveram relacionamento com a empresa, mas estão há algum tempo sem realizar uma nova compra.
Esse tipo de pergunta aparece bastante no mundo real.
E é um ótimo exemplo de como SQL pode ser utilizado para muito mais do que simplesmente consultar registros.
Vamos investigar.
Primeiro: o que significa “está parando de comprar”?
Essa é a primeira pergunta que um analista deveria fazer.
Porque o banco de dados não possui uma coluna chamada:
ESTA_PARANDO_DE_COMPRARPrecisamos transformar uma ideia de negócio em uma regra que possa ser calculada.
Por exemplo, a empresa pode definir:
Cliente em risco de inatividade = cliente que já realizou pelo menos uma compra, mas está há mais de 90 dias sem comprar novamente.
Agora temos uma definição.
E isso muda tudo.
Antes da query vem a regra
Observe a diferença.
A pergunta inicial era subjetiva:
Quem está parando de comprar?
Agora temos algo mensurável:
Quais clientes possuem última compra anterior a 90 dias?
Essa transformação é parte importante do trabalho analítico.
Muitas vezes, o desafio não está em escrever SQL.
Está em transformar uma pergunta vaga em uma regra clara.
Quais informações precisamos?
Vamos imaginar duas tabelas.
A tabela cliente:
cliente
----------------
ID_CLIENTE
NOME
E a tabela pedido:
pedido
----------------
ID_PEDIDO
ID_CLIENTE
DATA_PEDIDO
VALOR_TOTAL
Precisamos descobrir:
- quem é o cliente;
- quais pedidos ele realizou;
- qual foi a data da última compra;
- há quanto tempo essa compra aconteceu.
Perceba que ainda não escrevemos SQL.
Estamos apenas organizando o problema.
Qual foi a última compra de cada cliente?
Vamos começar pela pergunta mais simples:
Qual foi a última compra realizada por cada cliente?
Se um cliente possui vários pedidos, precisamos encontrar a maior data.
É aqui que MAX() aparece naturalmente.
SELECT
    P.ID_CLIENTE,
    MAX(P.DATA_PEDIDO) AS DATA_ULTIMA_COMPRA
FROM pedido P
GROUP BY
    P.ID_CLIENTE;
Imagine que o resultado seja:
| ID_CLIENTE | DATA_ULTIMA_COMPRA |
|---|---|
| 1 | 2026-09-20 |
| 2 | 2026-09-15 |
| 3 | 2026-05-02 |
| 4 | 2026-09-18 |
| 5 | 2026-04-10 |
Agora já temos uma informação muito mais interessante.
Não estamos olhando para cada pedido.
Estamos olhando para o último momento em que cada cliente comprou.
Por que usamos GROUP BY?
Porque MAX() precisa ser calculado para cada cliente.
Sem o agrupamento:
SELECT
    MAX(DATA_PEDIDO)
FROM pedido;
teríamos apenas:
a compra mais recente de toda a empresa.
Mas nossa pergunta é diferente.
Queremos:
a compra mais recente de cada cliente.
Por isso:
GROUP BY P.ID_CLIENTECada cliente forma um grupo.
E MAX() encontra a maior data dentro desse grupo.
Agora precisamos do nome do cliente
Podemos relacionar cliente e pedido.
SELECT
    C.ID_CLIENTE,
    C.NOME,
    MAX(P.DATA_PEDIDO) AS DATA_ULTIMA_COMPRA
FROM cliente C
INNER JOIN pedido P
    ON C.ID_CLIENTE = P.ID_CLIENTE
GROUP BY
    C.ID_CLIENTE,
    C.NOME;
Agora temos algo parecido com:
| Cliente | Última compra |
|---|---|
| Ana | 20/09/2026 |
| Carlos | 15/09/2026 |
| Mariana | 02/05/2026 |
| João | 18/09/2026 |
| Fernanda | 10/04/2026 |
Já conseguimos enxergar dois clientes que merecem atenção.
Mariana.
Fernanda.
Mas o SQL ainda precisa aplicar nossa regra.
Agora entra o período de inatividade
Nossa definição foi:
clientes que estão há mais de 90 dias sem comprar.
Aqui existe um detalhe técnico.
A forma de trabalhar com datas muda entre bancos de dados.
No SQL Server, por exemplo, poderíamos trabalhar com DATEADD().
Considerando como referência a data de 23/09/2026, poderíamos escrever:
SELECT
    C.ID_CLIENTE,
    C.NOME,
    MAX(P.DATA_PEDIDO) AS DATA_ULTIMA_COMPRA
FROM cliente C
INNER JOIN pedido P
    ON C.ID_CLIENTE = P.ID_CLIENTE
GROUP BY
    C.ID_CLIENTE,
    C.NOME
HAVING MAX(P.DATA_PEDIDO) < DATEADD(DAY, -90, '2026-09-23');
Agora estamos dizendo:
Mostre apenas clientes cuja última compra aconteceu há mais de 90 dias da data utilizada como referência.
Por que HAVING e não WHERE?
Essa é uma parte muito interessante do problema.
Talvez você pense:
“Por que não colocar a condição no
WHERE?”
Porque não estamos filtrando pedidos individuais.
Estamos filtrando o resultado de:
MAX(P.DATA_PEDIDO)E esse valor só existe depois que os pedidos foram agrupados por cliente.
Lembre da diferença:
WHERE
Filtra registros antes do agrupamento.
HAVING
Filtra grupos depois da agregação.
Nossa pergunta é:
Quais clientes possuem última compra anterior a determinada data?
Por isso HAVING faz sentido.
Veja como a pergunta gerou os comandos
Observe a sequência.
Precisamos relacionar clientes e pedidos.
Surge:
JOINPrecisamos encontrar a última compra.
Surge:
MAX()Precisamos calcular isso por cliente.
Surge:
GROUP BYPrecisamos filtrar o resultado agregado.
Surge:
HAVINGIsso é muito diferente de estudar:
Hoje vou praticar
HAVING.
No problema real, o HAVING apareceu porque a pergunta exigiu.
Mas temos um problema escondido
Observe que utilizamos:
INNER JOIN pedido PIsso significa que apenas clientes que possuem pelo menos um pedido aparecem.
Neste caso, isso faz sentido.
Nossa pergunta é:
Quem comprava e está há muito tempo sem comprar?
Um cliente que nunca comprou representa outro problema.
Ele não está “parando de comprar”.
Ele simplesmente nunca comprou.
Essa distinção é importante.
Cliente sem compra e cliente inativo não são a mesma coisa
Imagine:
Cliente A
Cadastrado há seis meses.
Nunca realizou pedido.
Cliente B
Realizou 15 pedidos durante dois anos.
Está há quatro meses sem comprar.
Os dois podem estar sem pedidos recentes.
Mas representam situações completamente diferentes para o negócio.
Cliente A pode precisar de uma estratégia de primeira conversão.
Cliente B pode precisar de uma estratégia de reativação.
Por isso, antes de escrever a consulta, precisamos saber qual comportamento estamos procurando.
90 dias é sempre a regra correta?
Não.
E esse talvez seja o ponto mais importante deste artigo.
Imagine uma cafeteria.
Um cliente que não compra há 90 dias pode estar completamente inativo.
Agora imagine uma loja de móveis.
Talvez seja normal alguém passar mais de 90 dias entre uma compra e outra.
Ou uma concessionária.
O intervalo esperado pode ser de anos.
Então a regra:
90 dias = cliente em risco
não deveria nascer do SQL.
Ela deveria nascer do contexto do negócio.
Como poderíamos definir uma regra melhor?
Existem várias possibilidades.
Uma empresa pode considerar:
cliente inativo após 60 dias.
Outra:
cliente inativo após 180 dias.
Mas também podemos ir além de um número fixo.
Podemos analisar o histórico de cada cliente.
Imagine alguém que costumava comprar a cada 15 dias.
Agora está há 60 dias sem comprar.
Isso pode ser um sinal importante.
Enquanto outro cliente normalmente compra a cada quatro meses.
Para ele, 60 dias não significa nada.
Percebe como o problema começa a ficar mais interessante?
SQL permite evoluir a análise
Nossa primeira consulta encontrou clientes cuja última compra aconteceu há mais de 90 dias.
Mas podemos continuar.
Por exemplo:
Quanto esses clientes costumavam comprar?
Podemos calcular:
SUM(P.VALOR_TOTAL)Ou:
Quantos pedidos eles já realizaram?
COUNT(P.ID_PEDIDO)Agora poderíamos encontrar algo assim:
| Cliente | Última compra | Pedidos | Total histórico |
|---|---|---|---|
| Mariana | 02/05/2026 | 18 | R$ 8.400 |
| Fernanda | 10/04/2026 | 2 | R$ 190 |
As duas estão inativas.
Mas será que possuem a mesma importância para o negócio?
Provavelmente não.
Podemos melhorar nossa consulta
Por exemplo:
SELECT
    C.ID_CLIENTE,
    C.NOME,
    MAX(P.DATA_PEDIDO) AS DATA_ULTIMA_COMPRA,
    COUNT(P.ID_PEDIDO) AS TOTAL_PEDIDOS,
    SUM(P.VALOR_TOTAL) AS VALOR_TOTAL_COMPRADO
FROM cliente C
INNER JOIN pedido P
    ON C.ID_CLIENTE = P.ID_CLIENTE
GROUP BY
    C.ID_CLIENTE,
    C.NOME
HAVING MAX(P.DATA_PEDIDO) < DATEADD(DAY, -90, '2026-09-23')
ORDER BY
    VALOR_TOTAL_COMPRADO DESC;
Agora não temos apenas uma lista de clientes inativos.
Temos informações que podem ajudar a priorizar uma ação.
O ORDER BY também conta uma história
Observe:
ORDER BY
    VALOR_TOTAL_COMPRADO DESC;
Por que fizemos isso?
Porque talvez faça sentido olhar primeiro para clientes que já tiveram maior valor histórico.
Novamente:
o comando não está ali porque queremos praticar ORDER BY.
Ele existe porque temos uma intenção:
priorizar clientes potencialmente mais relevantes.
Mas cuidado com uma conclusão precipitada
Imagine que Mariana tenha comprado R$ 8.400 no passado e esteja há quatro meses sem comprar.
Podemos dizer:
Mariana não compra há mais de 90 dias e possui um histórico relevante de compras.
Isso é um fato.
Mas não podemos afirmar automaticamente:
Mariana abandonou a empresa porque está insatisfeita.
O banco não mostrou isso.
Pode existir uma série de motivos:
- mudança de necessidade;
- sazonalidade;
- mudança de endereço;
- produto indisponível;
- concorrência;
- alteração de preço;
- simples comportamento natural.
SQL ajuda a encontrar o sinal.
Não necessariamente explica a causa.
Encontrar o cliente é o começo da análise
Depois de identificar esses clientes, podemos investigar.
Por exemplo:
- Qual era a frequência média de compra deles?
- Houve queda gradual ou interrupção repentina?
- Eles compravam determinados produtos?
- Esses produtos continuam disponíveis?
- Alguma região concentra mais clientes inativos?
- Existe alguma mudança de preço relacionada?
Cada pergunta pode gerar uma nova consulta.
É exatamente isso que vimos no artigo anterior:
a query terminar não significa que a análise terminou.
Podemos transformar isso em segmentação
Imagine que a empresa queira criar três grupos:
ATIVO
Comprou nos últimos 30 dias.
ATENÇÃO
Última compra entre 31 e 90 dias.
INATIVO
Mais de 90 dias sem comprar.
Agora podemos combinar nosso raciocínio com CASE WHEN.
Por exemplo:
SELECT
    C.ID_CLIENTE,
    C.NOME,
    MAX(P.DATA_PEDIDO) AS DATA_ULTIMA_COMPRA,
    CASE
        WHEN MAX(P.DATA_PEDIDO) >= DATEADD(DAY, -30, '2026-09-23')
            THEN 'ATIVO'
        WHEN MAX(P.DATA_PEDIDO) >= DATEADD(DAY, -90, '2026-09-23')
            THEN 'ATENÇÃO'
        ELSE 'INATIVO'
    END AS STATUS_CLIENTE
FROM cliente C
INNER JOIN pedido P
    ON C.ID_CLIENTE = P.ID_CLIENTE
GROUP BY
    C.ID_CLIENTE,
    C.NOME;
Perceba como os conteúdos começam a se conectar.
No início do mês aprendemos CASE WHEN.
Agora estamos utilizando o mesmo recurso dentro de um problema mais completo.
Isso é evolução.
E existe um próximo nível
Podemos deixar o problema ainda mais próximo de uma análise real.
Em vez de perguntar:
Quem está há 90 dias sem comprar?
Podemos perguntar:
Quais clientes estão comprando com menos frequência do que costumavam?
Agora não basta olhar para a última compra.
Precisamos entender o comportamento histórico.
Talvez comparar:
frequência anterior
        ↓
frequência atual
Ou:
compras últimos 90 dias
        ↓
compras 90 dias anteriores
Esse problema pode exigir CTEs.
Agregações.
Comparações entre períodos.
Talvez funções de janela.
Ou seja:
o mesmo problema pode crescer conforme a profundidade da pergunta aumenta.
Esse é o tipo de SQL que vale a pena praticar
Compare dois exercícios.
Exercício A
Utilize
MAX()comGROUP BY.
Exercício B
A empresa percebeu queda na recompra e quer identificar clientes que estão há mais de 90 dias sem realizar pedidos. Quem deveria ser analisado primeiro?
Os dois podem utilizar MAX() e GROUP BY.
Mas o segundo obriga você a pensar.
Você precisa entender:
- o contexto;
- a definição;
- as tabelas;
- o relacionamento;
- a agregação;
- o filtro;
- a interpretação.
É esse tipo de prática que aproxima SQL do trabalho real.
Um desafio para você
Imagine que a empresa mudou a regra.
Agora existem quatro classificações:
- compra nos últimos 30 dias →
ATIVO; - entre 31 e 60 dias →
ATENÇÃO; - entre 61 e 120 dias →
RISCO; - mais de 120 dias →
INATIVO.
Tente modificar a consulta utilizando CASE WHEN.
Mas não comece pelo código.
Primeiro escreva as regras.
Depois organize a ordem das condições.
Só então transforme em SQL.
Um segundo desafio
Agora imagine outra pergunta:
Quais clientes inativos já realizaram pelo menos cinco pedidos e gastaram mais de R$ 2.000?
Observe quantos conceitos aparecem:
- relacionamento;
- agregação;
- última data;
- contagem;
- soma;
- filtros sobre agregações.
Você provavelmente precisará trabalhar com:
JOIN
MAX()
COUNT()
SUM()
GROUP BY
HAVING
Mas, novamente, não comece pelos comandos.
Comece pela pergunta.
O que aprendemos neste mini-case?
Tecnicamente, trabalhamos com:
INNER JOIN;MAX();COUNT();SUM();GROUP BY;HAVING;ORDER BY;- datas;
CASE WHEN.
Mas existe um aprendizado mais importante.
Começamos com uma pergunta vaga:
Quem está parando de comprar?
Transformamos em uma regra:
clientes que já compraram, mas estão há mais de 90 dias sem nova compra.
Depois identificamos os dados.
Construímos a consulta.
Validamos o significado.
E finalmente começamos a pensar em ações e novas investigações.
Esse é o caminho.
Problema → definição → dados → SQL → interpretação.
Conclusão
Encontrar clientes que estão parando de comprar não começa com:
MAX(DATA_PEDIDO)Começa com uma pergunta:
O que significa um cliente estar se afastando para este negócio?
Depois que essa definição está clara, o SQL começa a aparecer naturalmente.
Precisamos da última compra.
Usamos MAX().
Precisamos calcular por cliente.
Usamos GROUP BY.
Precisamos filtrar os clientes com última compra antiga.
Usamos HAVING.
Precisamos entender quem merece maior atenção.
Adicionamos outras informações.
É assim que os comandos começam a deixar de parecer assuntos separados.
Eles passam a trabalhar juntos para resolver um problema.
E esse é um dos momentos em que SQL começa a ficar realmente interessante.
Próximo passo
Na Coleção A Arte da Query, a prática segue justamente essa lógica.
Você não recebe apenas uma instrução como:
“Faça um
GROUP BY.”
Você encontra cenários em que precisa entender o contexto, interpretar a pergunta e decidir quais recursos SQL fazem sentido para chegar à resposta.
Porque no trabalho real dificilmente alguém vai pedir:
“Use
MAX()comHAVING.”
A pergunta será muito mais parecida com:
“Quais clientes importantes estão deixando de comprar?”
E a habilidade que faz diferença é conseguir transformar essa pergunta em uma investigação utilizando SQL.
Link: https://artedaquery.com.br/


0 Comentários